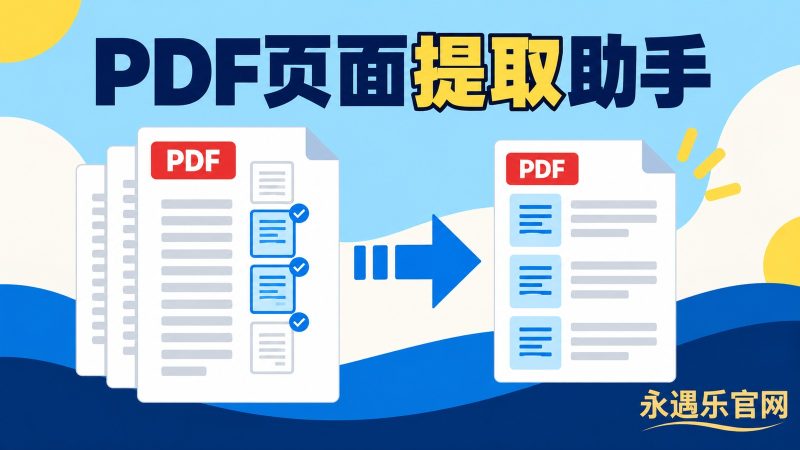

长PDF只需要其中几页,不想把整份文件都发出去?选择一个本地普通PDF,填写物理页码,把选中的页面按顺序保存为一个新PDF。
下载后本机使用
本页是功能说明与静态操作画面,不嵌入在线工具。完整离线包版本1.0.0,下载并解压后打开 index.html;无需安装、无需登录,不联网。
使用方法
- 完整解压ZIP,用Windows Chrome或Edge打开 index.html;请保留同目录vendor及许可证文件。
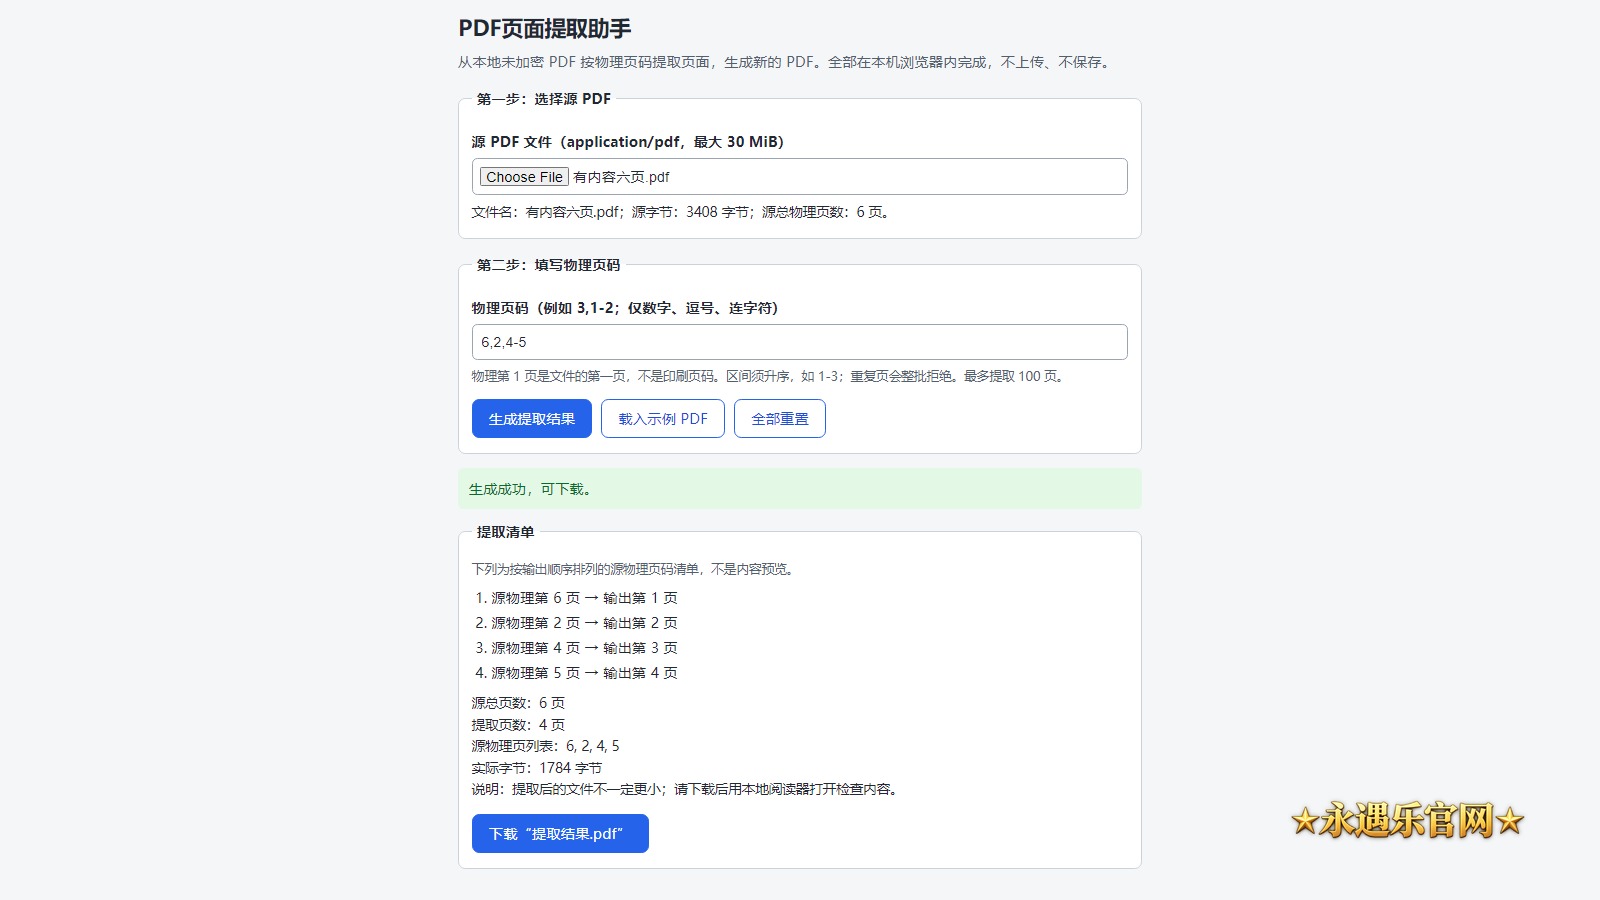
- 选入未加密普通PDF,核对文件名、源字节和物理总页数;物理第1页不是页面上印刷的页码。
- 输入如3,1-2的页码,按出现顺序提取;不要加空格、重复页或倒序区间。
- 生成并核对源页列表、输出页数和实际字节,下载新PDF后用本地阅读器重新打开检查内容。
本地处理边界
单文件最多30MiB、300物理页,一次提取1–100页。页码只接受规范正整数、英文逗号和连字符,越界、重复、空项、前导零或反序区间整体拒绝。不支持加密、损坏或含交互表单字段的文档,不尝试密码或绕过保护。按页面复制保留页面尺寸与旋转,不把原页栅格化;不保证签名、书签、链接、附件和结构标签保留,不做OCR、压缩、内容编辑或安全净化,输出也不一定比原文件小。页面只显示源页码清单,不提供PDF内容预览;原件不覆盖。pdf-lib 1.17.1及MIT许可证随包本地提供,工具运行不从网络加载。
输入只在当前浏览器内存中处理,不上传、不保存;关闭或刷新前请自行导出。Windows桌面Chrome的输入到输出已实测;390px浏览器布局已测试,但手机本地HTML打开依赖系统与浏览器能力。
下载链接
下载前请确认
下载离线包链接会打开下载页面;以下说明仅依据当前文章和已回读的下载清单生成。
- 版本
- 1.0.0
- 更新日
- 2026年10月21日
- 文件类型
- ZIP 离线工具包
- 安装方式
- 无需安装,解压后直接打开
- 联网情况
- 不联网
- 如何打开
- 解压后双击 index.html
© 版权声明
文章版权归作者所有,未经允许请勿转载。
THE END